728x90

안녕하십니까,
부매경입니다.
오늘은 합성데이터(Synthetic Data)에 대해서 한번 알아보도록 하겠습니다.
최근 AI 모델을 학습시킬 때 실제 데이터를 직접 수집하는 대신, 컴퓨터로 데이터를 만들어 쓰는 사례가 크게 늘고 있습니다. 오늘은 이 합성데이터가 정확히 무엇이고 어떤 원리로 만들어지는지, 그리고 최근 화두가 되고 있는 모델 붕괴(model collapse) 리스크까지 함께 정리해보겠습니다.
합성데이터(Synthetic Data) 정의
- 합성데이터란 실제 사건이나 관측에서 수집된 데이터가 아니라, 알고리즘으로 인공적으로 만들어낸 데이터.
- IBM Research는 "실제 데이터를 모방하지만 알고리즘으로 생성된 인공 데이터"로 정의.
- NVIDIA는 합성데이터 생성(Synthetic Data Generation, SDG)을 "컴퓨터 시뮬레이션, 생성형 AI 모델, 혹은 둘의 결합을 이용해 텍스트·2D/3D 이미지·영상을 만들어내는 것"으로 정의.
- 실제 데이터가 부족하거나(scarce), 민감하거나(sensitive), 수집 비용이 비쌀 때 AI 모델 학습·검증용으로 활용됨.
합성데이터 생성 원리
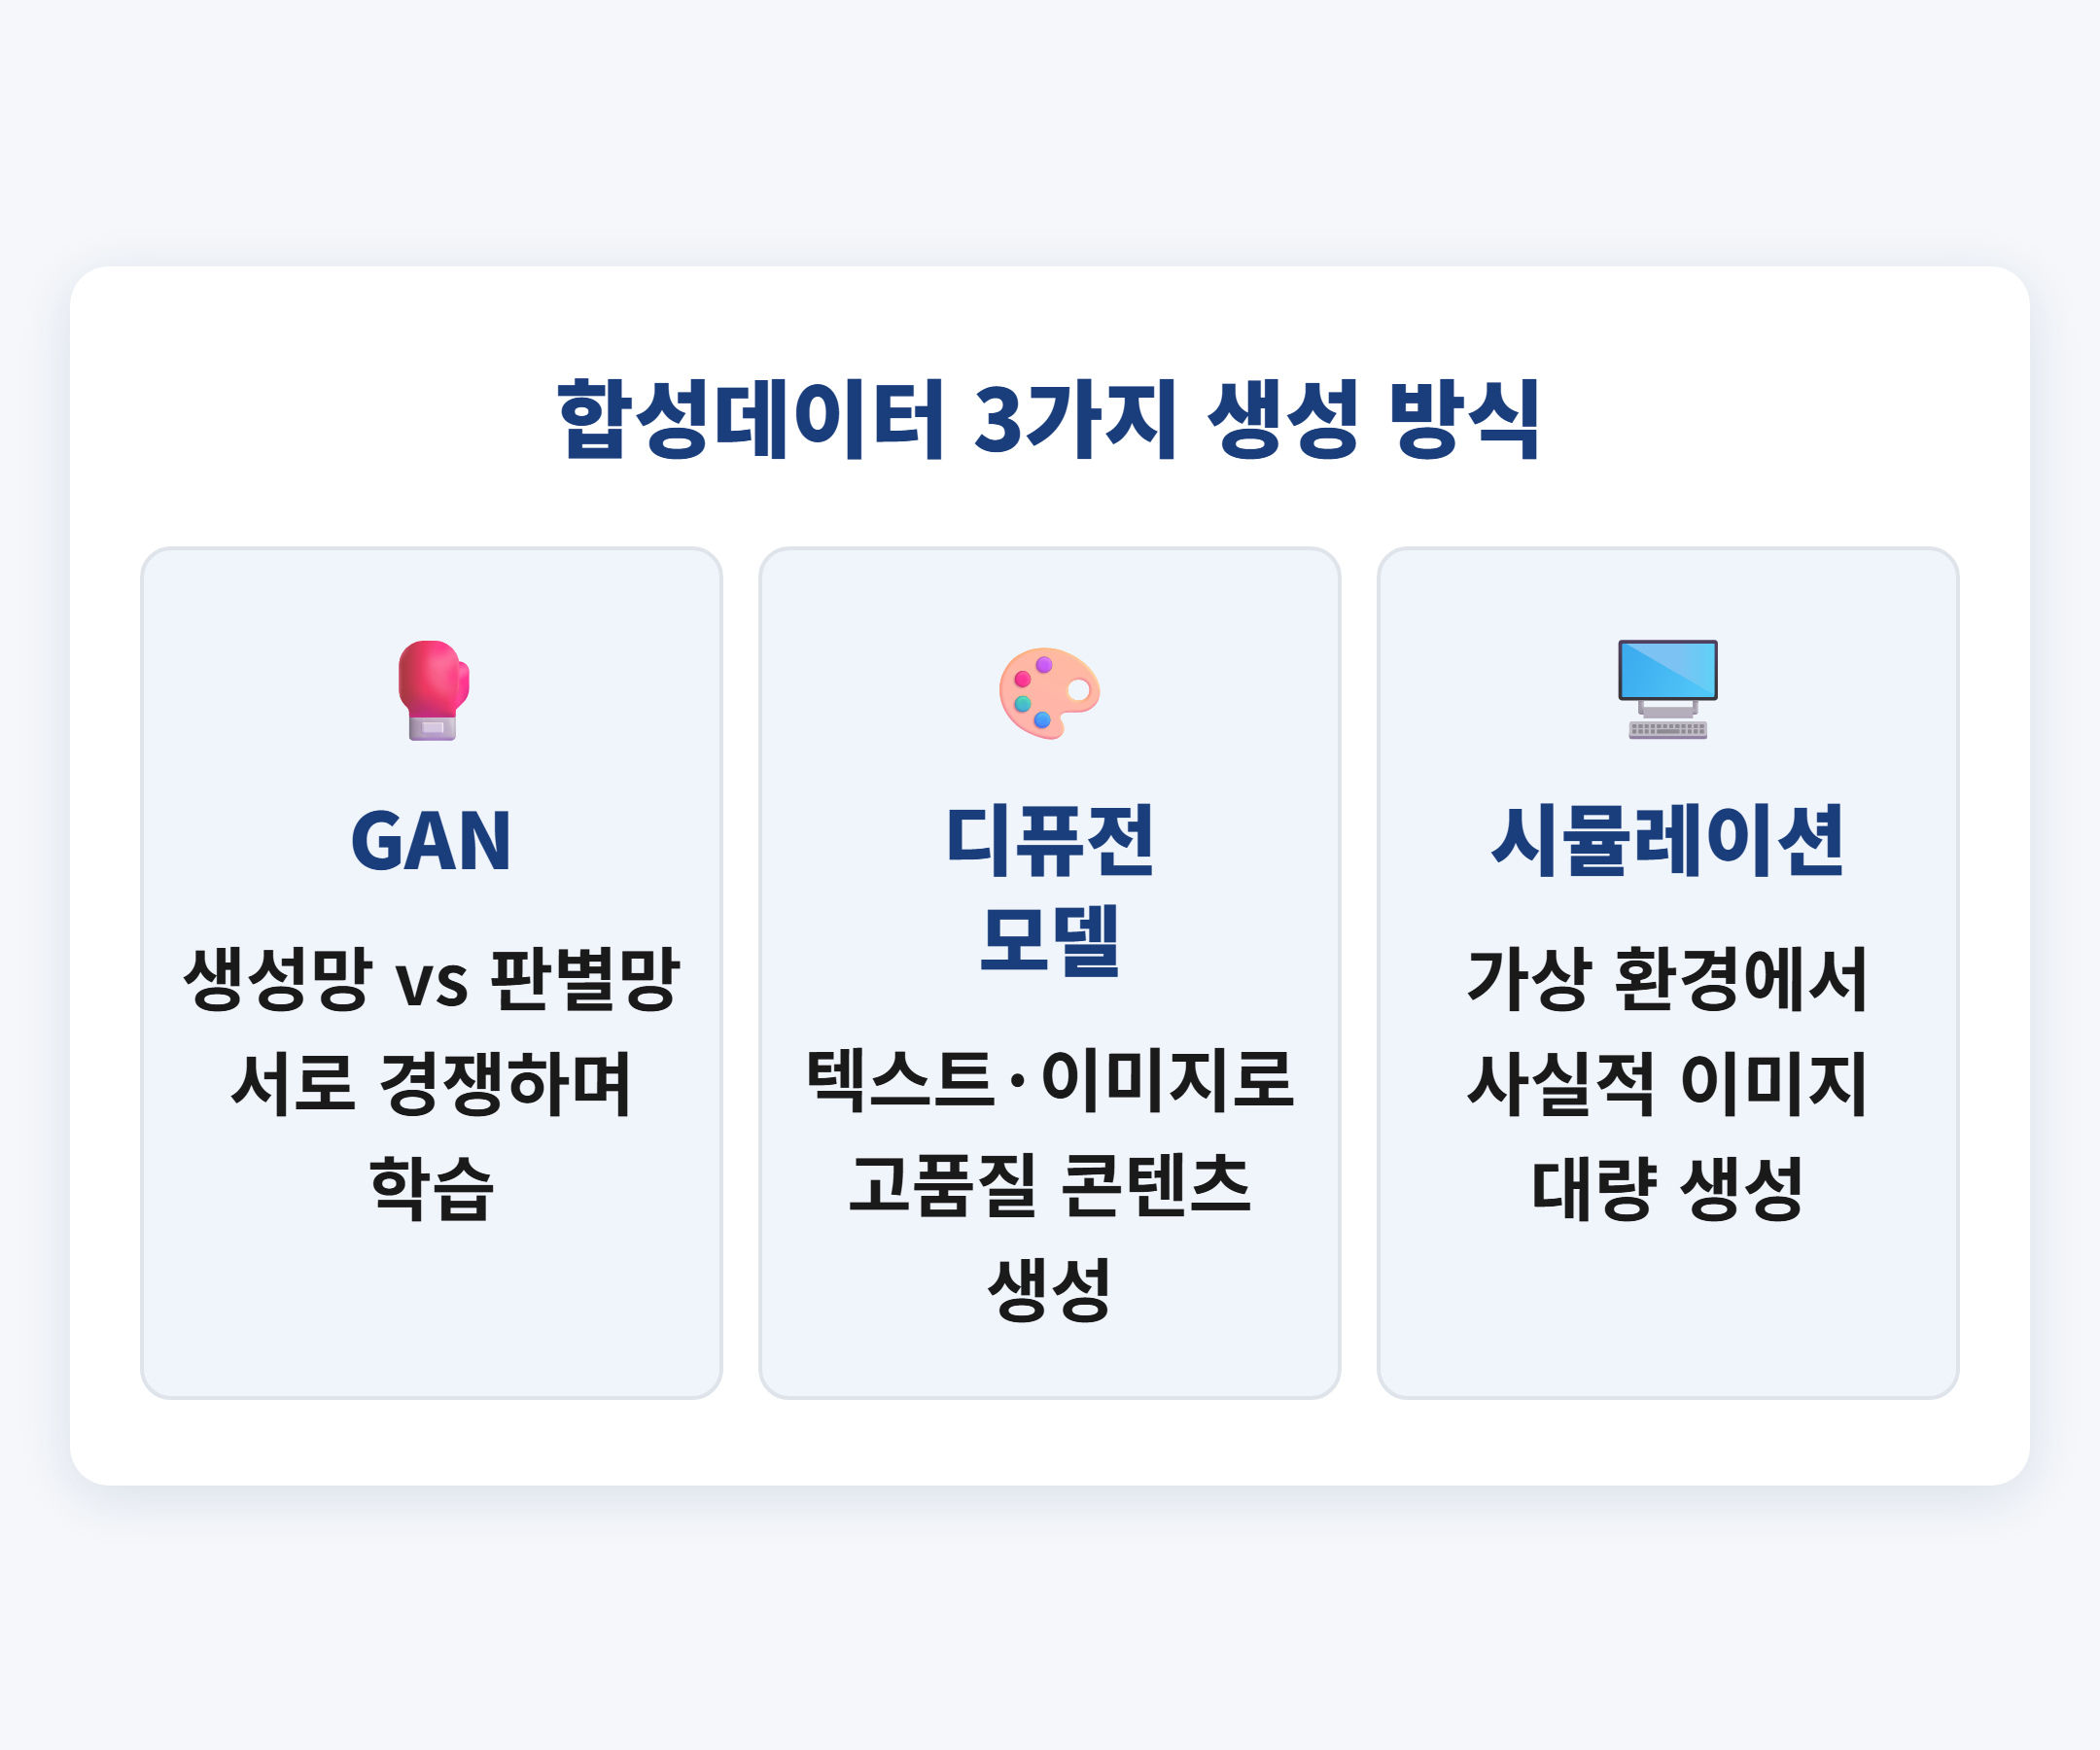
- GAN(생성적 적대 신경망) : 데이터를 만들어내는 신경망과, 이를 실제 데이터와 비교·판별하는 신경망이 서로 경쟁하며 학습하는 방식.
- 디퓨전 모델(Diffusion Model) : 텍스트나 이미지 설명으로부터 고품질 시각 콘텐츠 생성. 이미지와 텍스트 관계를 학습해 레이아웃·색상·사물 크기·조명 등을 프로그래밍적으로 조정 가능.
- 컴퓨터 시뮬레이션 : 그래픽 엔진 기반 가상 환경에서 사실적인 이미지·영상을 대량 생성. NVIDIA Omniverse Replicator가 대표적으로, 자율주행차 신경망 학습에 필요한 정답(ground truth) 포함 합성 센서 데이터를 만듦.
- LLM 텍스트 합성 : 기존 텍스트를 다른 모델이 재구성(rephrase)하거나 새로 생성하는 방식. Microsoft의 소형언어모델 Phi-4는 50종, 총 4,000억(400 billion) 토큰 규모의 합성 데이터셋으로 학습됨.
합성데이터 시장 규모와 확산 속도
- 가트너(Gartner) : 2021년 AI·분석 프로젝트에 쓰인 데이터 중 합성데이터 비중은 1%에 불과했으나, 2024년에는 60%까지 급증.
- 가트너 : 2026년 기준 기업의 약 75%가 AI 모델 학습에 어떤 형태로든 합성데이터를 사용 중(2024년 40% 미만에서 증가).
- 가트너 : 2028년까지 AI 학습의 80%가 합성데이터를 사용하고, 2030년까지는 합성데이터가 AI 모델에서 실제 데이터를 완전히 압도할 것으로 전망.
- 시장 규모 전망은 조사기관마다 차이가 있으나, 공통적으로 빠른 성장을 예상하고 있음.
| 조사기관 | 2026년 규모 | 장기 전망 | 연평균성장률(CAGR) |
|---|---|---|---|
| Precedence Research | 7억 9,134만 달러 | 2034년 69억 5,232만 달러 | 31.10% |
| Research and Markets | 27억 5,000만 달러 | 2030년 104억 8,000만 달러 | 39.7% |
| Coherent Market Insights 계열 | 7억 1,000만 달러 | 2031년 36억 7,000만 달러 | 38.96% |
| Technavio(AI 학습 데이터셋 전체) | 39억 달러 | 2033년 163억 달러 | - |
Technavio에 따르면 '모델 학습(Model Training)' 용도가 2026년 글로벌 합성데이터 시장의 약 46.3%를 차지하는 최대 응용 분야로 추정됨.
합성데이터 장점
- 프라이버시 보호 : 실제 환자 기록의 통계적 특성은 유지하면서 개인식별정보(PII)를 제거해 HIPAA·GDPR 등 규제 준수 지원, 국경 간 의료 데이터 협업 가능.
- 규제 준수 + 위험 최소화 : 은행권에서는 GDPR·PCI-DSS·HIPAA 등을 준수하면서 재식별(re-identification) 위험을 최소화하는 방식으로 이상거래 탐지 모델 학습에 활용.
- 데이터 부족 문제 해결 : 희귀질환 연구처럼 실제 데이터가 극히 부족한 분야에서 프라이버시를 보호하며 연구를 가속화.
- 개발 기간 단축 : 자율주행 분야에서 엣지 케이스(희귀 상황)를 프라이버시 문제 없이 빠르게 시뮬레이션해 프로젝트 일정을 최대 50%까지 단축 가능.
- 품질·다양성 통제 : Microsoft Phi-4는 합성데이터 중심 학습으로 AMC 수학 시험 91.8%를 기록, 훨씬 큰 모델을 능가하는 성능을 보여줌.
합성데이터 단점 (모델 붕괴 리스크)
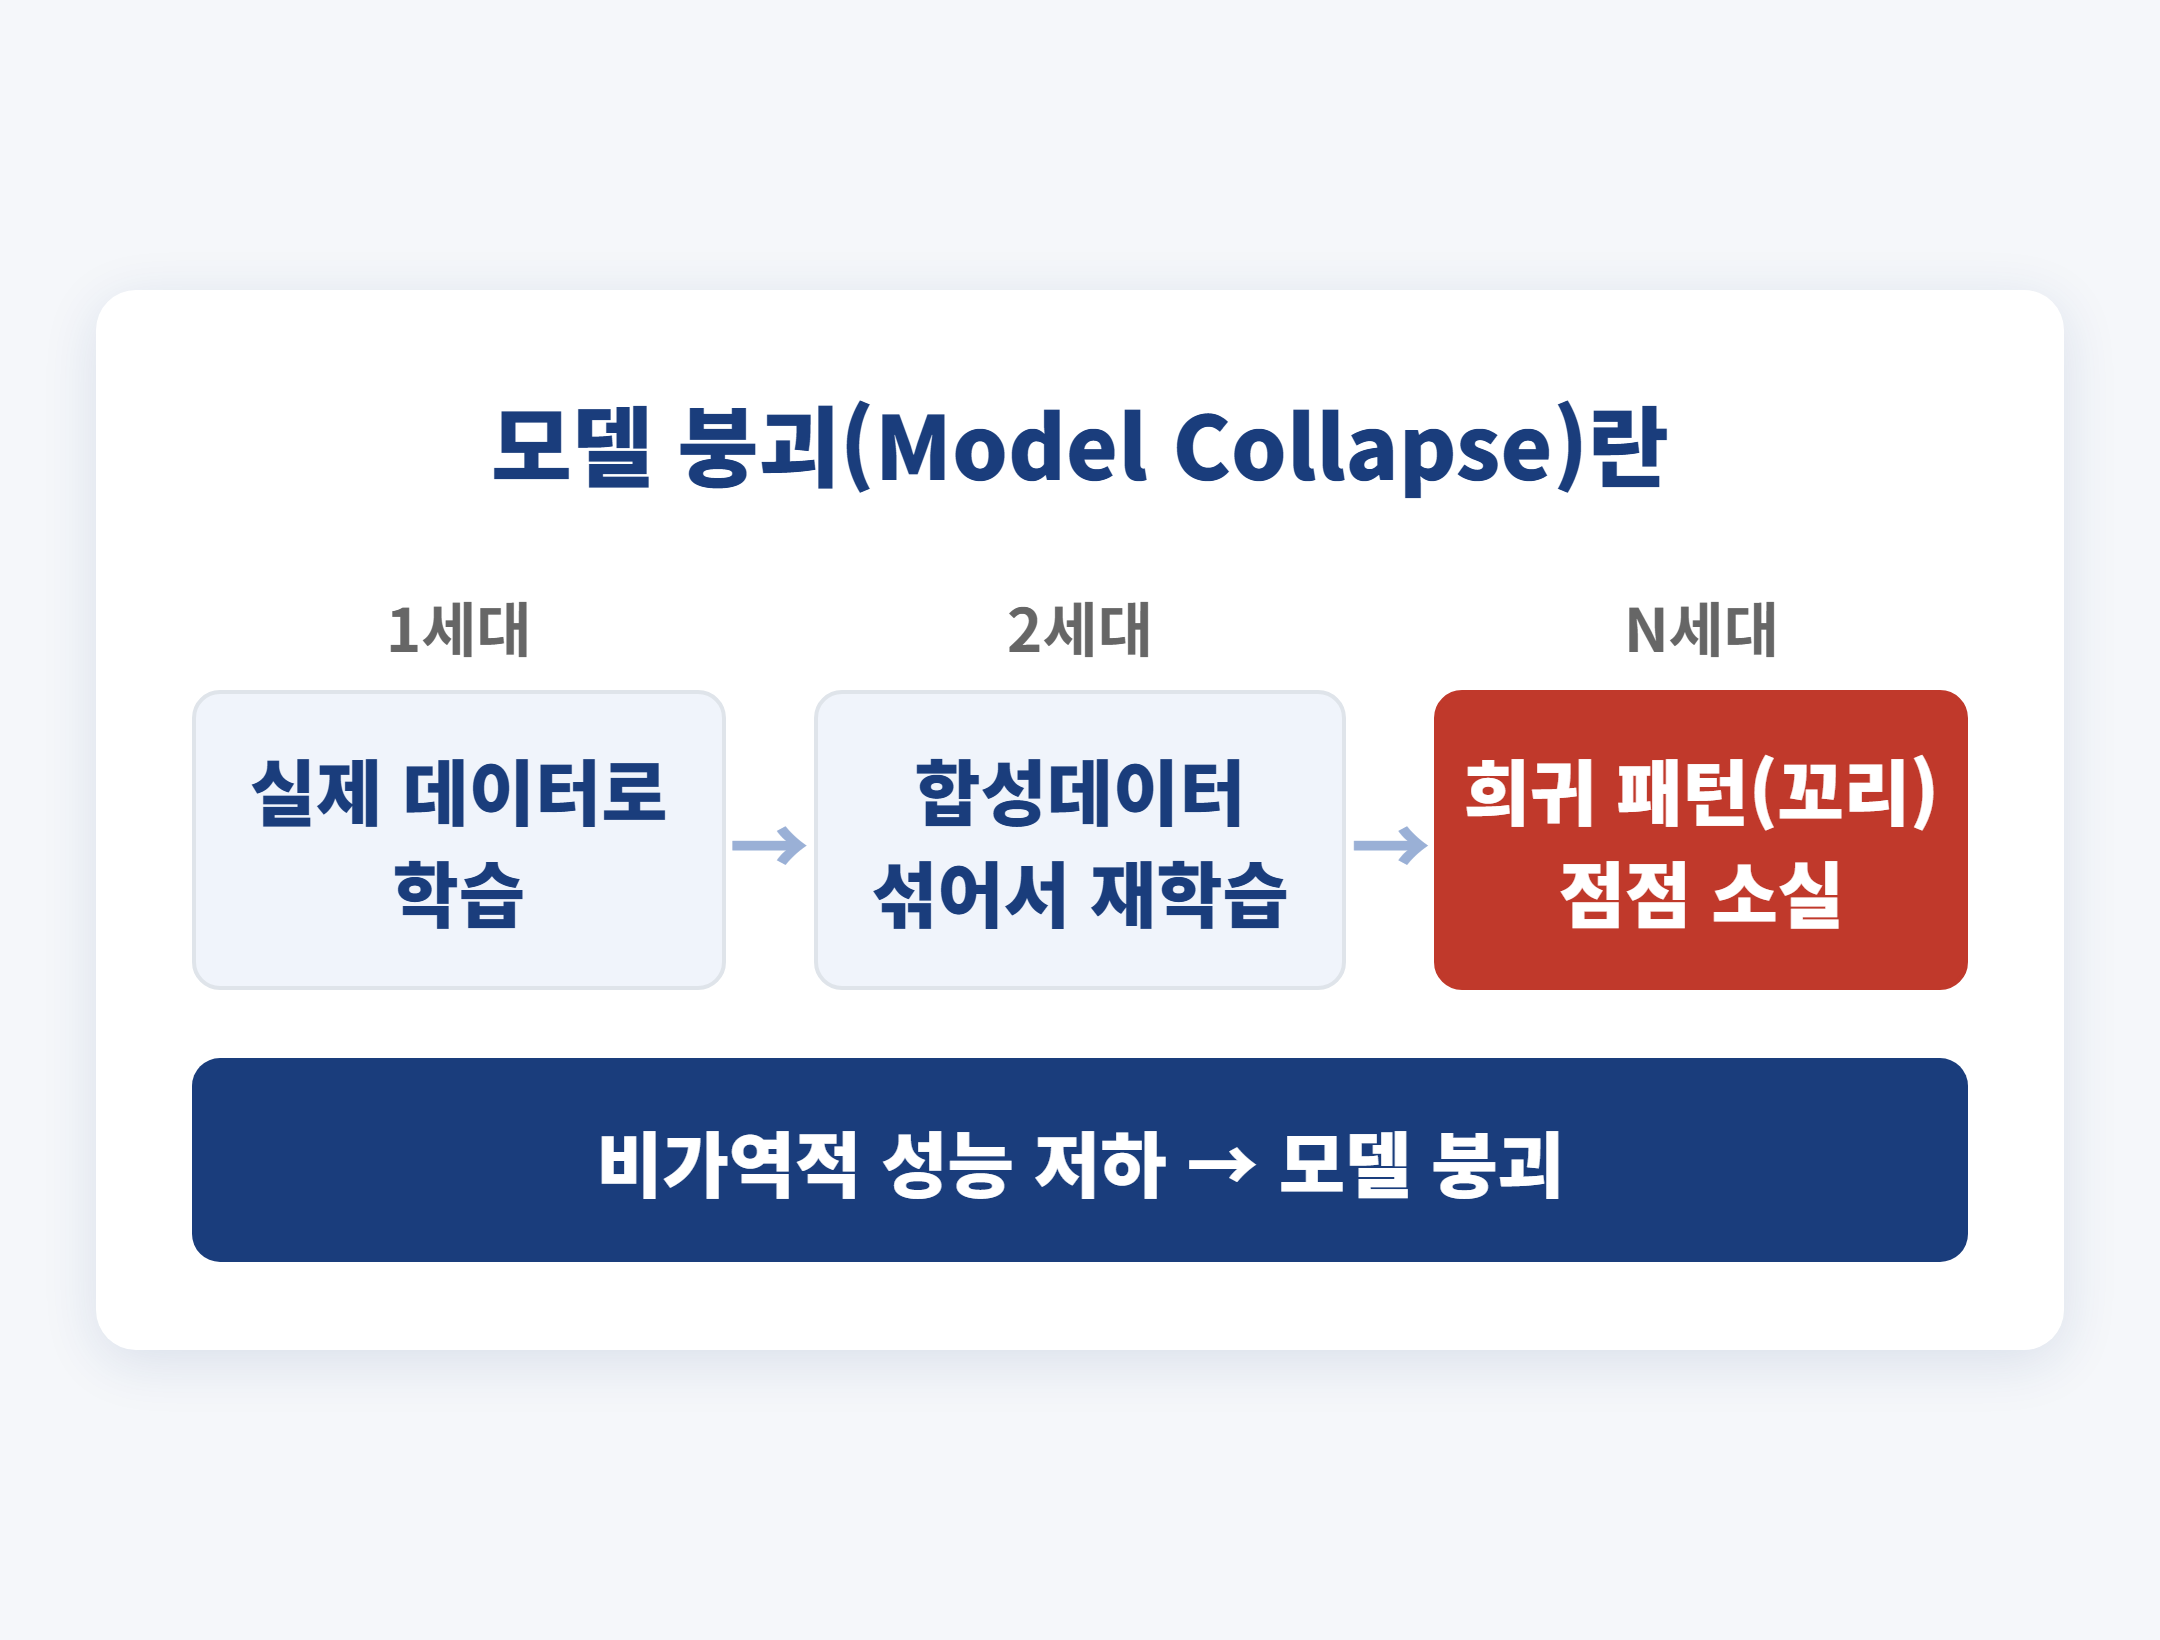
- 모델 붕괴(Model Collapse) : 네이처(Nature, 2024)에 게재된 Shumailov 외 연구에 따르면, 실제 데이터와 생성된 데이터를 무분별하게 섞어 학습시키면 원본 데이터 분포의 꼬리(tail, 희귀 패턴)가 사라지는 비가역적 결함이 발생. 이 현상은 LLM뿐 아니라 변분 오토인코더(VAE), 가우시안 혼합 모델에서도 나타남.
- 후속 통계 분석 연구 : 1000개 중 1개 수준의 아주 작은 비율의 합성데이터만 섞여도 모델 붕괴가 일어날 수 있으며, 순수하게 합성데이터로만 학습하면 모델 붕괴는 항상 발생.
- 완화 방법 : 실제 데이터와 합성데이터를 일정 비율 이하로 섞거나, 세대를 거듭할 때마다 원본 데이터를 누적해서 함께 학습시키는 방법이 제시됨.
- 의료 분야 리스크 : 실제 환자 데이터를 기반으로 한 합성데이터는 과적합(overfitting)으로 원본 기록을 그대로 복제하거나, 멤버십 추론(membership inference)·연결 공격(linkage attack)으로 재식별될 위험. 아직 합성 의료데이터 생성·평가 표준이 부재.
- 금융 분야 리스크 : 품질이 낮은 합성데이터는 오해를 부르는 패턴을 만들거나, 저빈도 이상 신호(실제 사기의 핵심 단서)를 모델이 무시하도록 학습시킬 위험.
- 거버넌스 리스크 : 가트너는 2027년까지 데이터·분석 리더의 60%가 합성데이터 관리 실패로 AI 거버넌스, 모델 정확도, 컴플라이언스 문제를 겪을 것으로 전망.
합성데이터 활용 사례
- NVIDIA Omniverse Replicator / DRIVE Sim : 자율주행차 인지 시스템을 구성하는 딥러닝 신경망 학습에 필요한 정답 레이블 포함 합성 센서 데이터 생성.
- NVIDIA Omniverse NuRec · Cosmos : 실제 주행 기록을 재구성해 새로운 카메라 시점을 렌더링하고, 롱테일(희귀) 시나리오를 생성해 자율주행 모델 테스트용 고충실도 센서 데이터 제작.
- Waabi(캐나다 자율주행 트럭 스타트업) : 생성형 AI 기반 클로즈드루프 시뮬레이터 'Waabi World'로 실제 도로에서 마주칠 수 있는 상황을 자동 생성, 도메인 갭이 거의 없는 상태로 자율주행 시스템 전체를 테스트. 우버·코슬라벤처스가 주도한 2억 달러 규모 시리즈B를 유치했고, 텍사스 공공도로에서 무인 트럭 상용화를 추진 중.
- Microsoft Phi-4 : 50종·4,000억 토큰 규모 합성데이터로 학습, 훨씬 큰 모델과 맞먹거나 능가하는 수학·추론 성능 달성.
- 스카이인텔리전스(국내 스타트업) : NVIDIA Omniverse 기반 디지털 트윈 환경에서 로봇 학습용 3D 합성데이터를 대량 자동 생성. NVIDIA ISV(독립 소프트웨어 벤더) 파트너이며, 2026년 6월 ABB로보틱스와 전략적 협력 프레임워크를 체결해 합성데이터로 학습한 AI 모델을 ABB 로봇에서 검증 중.
- 씨이랩(국내 기업) : 디지털 트윈 사업부에서 자체 합성데이터 솔루션 'X-GEN'과 NVIDIA Omniverse 플랫폼을 결합해 현실과 동일한 가상 환경 구현.
합성데이터 관련주
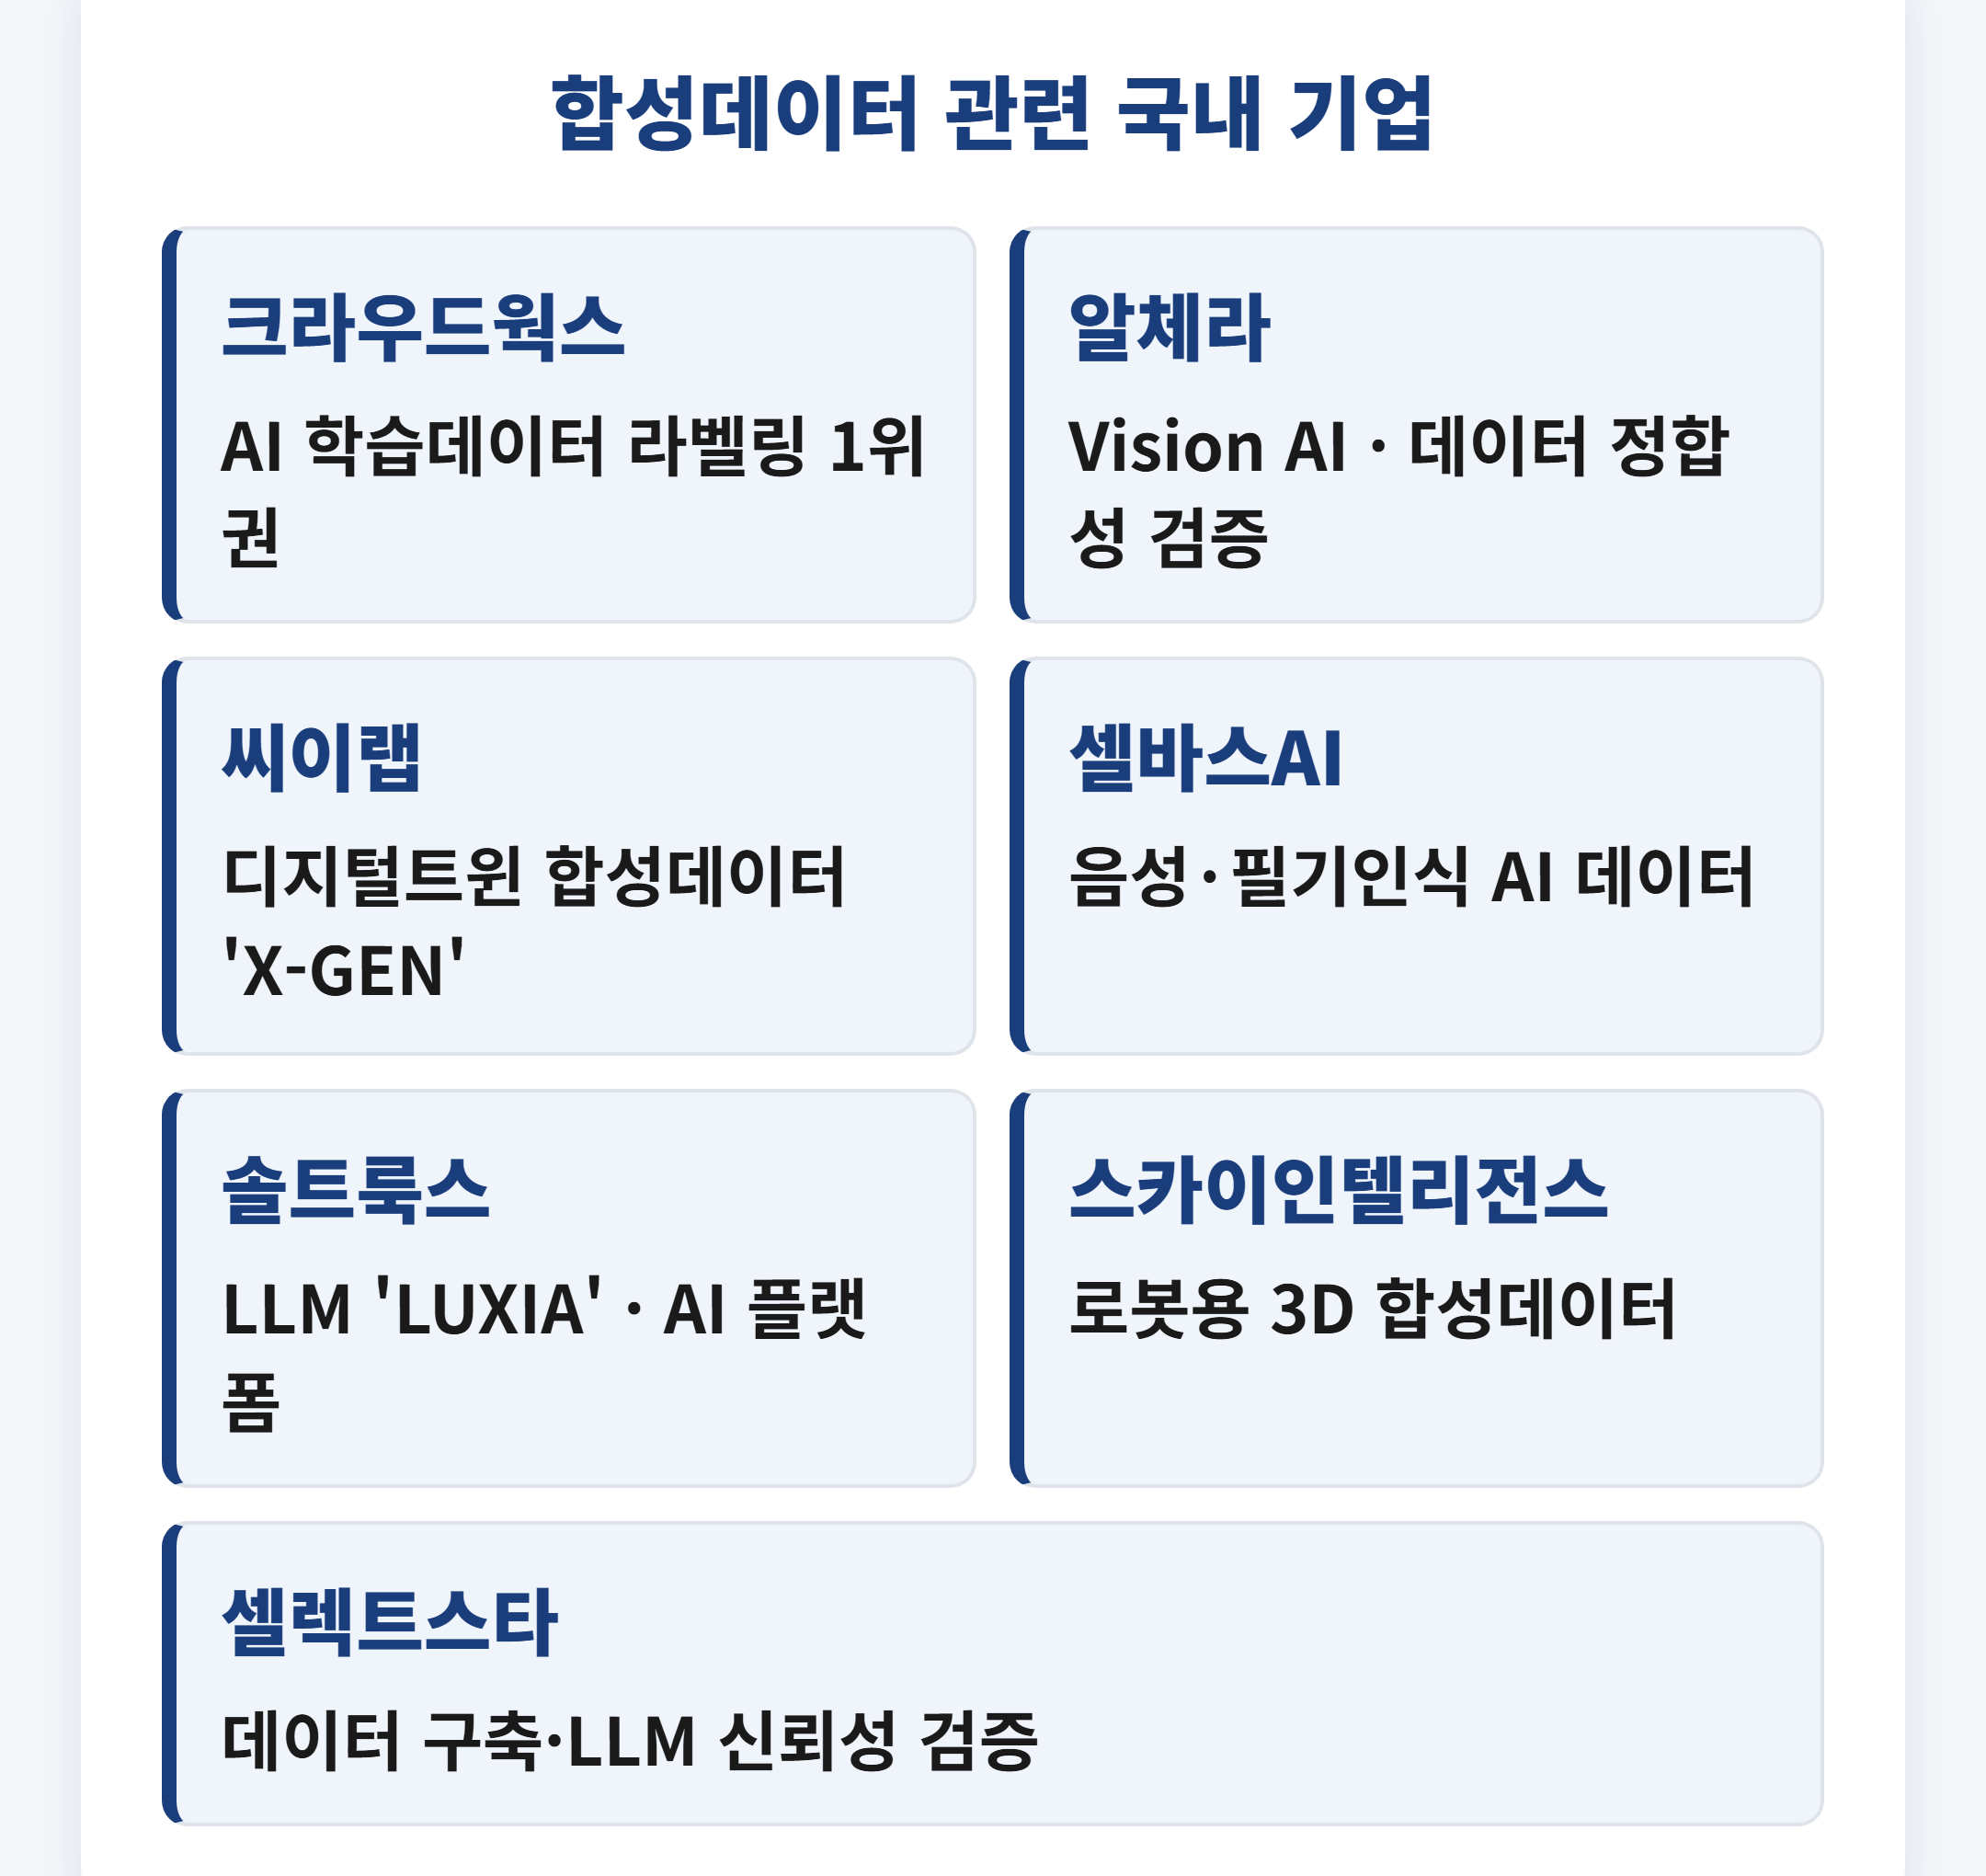
- 크라우드웍스(코스닥 355390) : AI 학습데이터 라벨링 국내 1위권 기업으로, AI 학습·성능 고도화용 데이터를 거래하는 'A1 데이터 마켓플레이스'를 운영. 가트너로부터 '생성형 AI 이머징 리더'로 선정됨.
- 알체라(코스닥 347860) : Vision AI 솔루션 기업으로, TTA '초거대 AI 학습용 데이터 의미적 정확성 검사' 사업 주관사에 4연속 선정. LLM·LMM용 데이터부터 합성데이터까지 AI 전방위 데이터 구축 서비스 제공.
- 씨이랩(코스닥 189330) : AI Infra·Vision AI·Digital Twin 3개 사업부 운영. Digital Twin 사업에서 자체 합성데이터 솔루션 'X-GEN'과 NVIDIA Omniverse 결합.
- 셀바스AI(코스닥 108860) : 딥러닝 기반 HCI(음성인식·필기인식) 기술 보유 기업. Edu-Tech·Healthcare·Mobility 도메인에 AI 음성기록·의료 음성인식 솔루션 공급, 고품질 AI 학습데이터 확보·가공 역량 보유.
- 솔트룩스(코스닥 304100, 시가총액 약 3,980억원) : 초거대 언어모델 'LUXIA' 등 LLM·AI 플랫폼 사업을 하는 국내 AI 전문기업. 자회사 다이퀘스트는 2027년 코스닥 상장을 목표로 프리IPO 152억원을 유치.
- 스카이인텔리전스(비상장 스타트업) : NVIDIA Omniverse 기반 디지털 트윈 환경에서 피지컬 AI(로봇)용 3D 합성데이터를 대량 자동 생성. NVIDIA ISV 파트너이자 ABB로보틱스와 전략적 협력 진행 중.
- 셀렉트스타(비상장 스타트업) : 데이터 설계 컨설팅·구축, RAG 기반 문서 데이터 정비, LLM 신뢰성 검증 수행. 2024년 기준 고객사 287개, 누적 작업 데이터 2억 건 이상.
- 관련주에 대한 더 자세한 투자 포인트는 세테식 블로그(thema-stock)의 합성데이터 관련주 분석 글에서 이어서 다룰 예정입니다.
합성데이터는 데이터 부족·프라이버시 문제를 동시에 해결할 수 있는 유력한 대안으로 빠르게 확산되고 있습니다. 다만 모델 붕괴처럼 아직 완전히 해결되지 않은 리스크도 분명히 존재합니다. 실제 데이터와의 적절한 비율 관리, 검증 체계 구축이 병행돼야 합성데이터의 장점을 온전히 살릴 수 있을 것으로 보입니다.
이상입니다. 감사합니다.
320x100